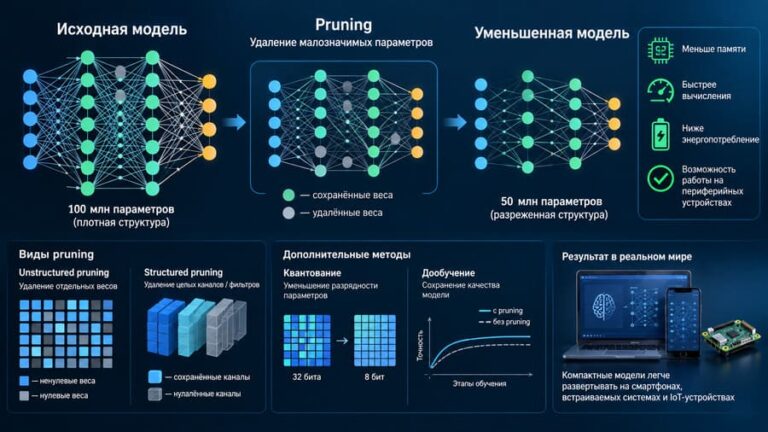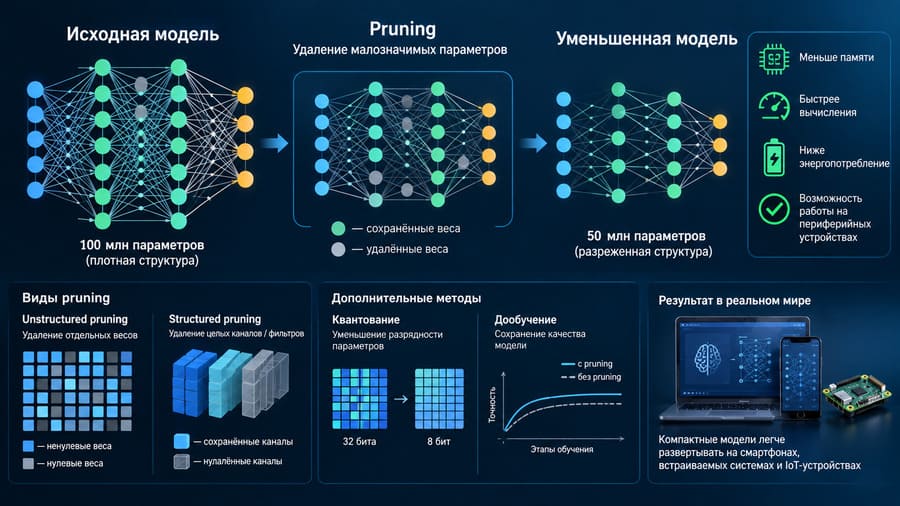
Современные нейросети нередко содержат миллионы, сотни миллионов и даже миллиарды параметров. Такая архитектура позволяет модели решать сложные задачи, однако одновременно увеличивает требования к памяти, вычислительной мощности и скорости обработки данных. Особенно заметной проблема становится при переносе обученной модели с мощного серверного оборудования на смартфон, промышленный контроллер, автомобильный компьютер или другое устройство с ограниченными ресурсами. Одним из способов оптимизации здесь становится pruning, или прореживание нейронной сети.
Суть pruning заключается в том, что после или во время обучения из модели удаляют часть параметров, связей, каналов либо других структурных элементов, которые считаются менее значимыми для результата. В самом простом случае отдельные веса заменяются нулевыми значениями. В более сложных вариантах удаляются целые группы параметров, например каналы сверточных слоев. В результате модель становится разреженной или получает уменьшенную структуру. При этом задача pruning состоит не просто в механическом удалении как можно большего количества элементов, а в поиске такого уровня сокращения, при котором выигрыш в размере и вычислительной эффективности оправдывает возможную потерю точности.
Что именно удаляется из нейросети
Чтобы понять принцип pruning, сначала нужно представить, из чего состоит обученная нейросеть. В процессе обучения ее параметры получают числовые значения, определяющие силу связей между отдельными элементами вычислительной структуры. Например, полносвязный слой может содержать матрицу весов размером 1000 на 1000 элементов. Теоретически это один миллион параметров только в одном слое. Однако далеко не каждый из этих параметров одинаково важен для конечного результата.
Некоторые веса имеют относительно небольшое абсолютное значение и могут оказывать ограниченное влияние на выход слоя. Если заменить часть таких весов нулями, математическая структура слоя сохранится, но часть соединений фактически перестанет участвовать в вычислении. Именно это и называется разреживанием. В PyTorch, например, стандартные методы pruning позволяют задавать долю параметров, которые необходимо обнулить, причем в качестве критерия может использоваться величина веса. В документации PyTorch отдельно предусмотрено как локальное pruning отдельных тензоров, так и глобальное pruning, при котором параметры сравниваются между несколькими слоями модели.
Важно различать физическое удаление параметра и его обнуление. Если модель по-прежнему хранит матрицу того же размера, но часть ее элементов равна нулю, количество математических позиций в массиве формально не изменилось. Поэтому простое присваивание нулей еще не гарантирует пропорционального уменьшения файла или ускорения вычислений. Чтобы pruning дал реальный эффект при развертывании, разреженные параметры должны поддерживаться форматом хранения, библиотекой вычислений или аппаратным ускорителем.
Почему маленькие веса можно удалять
Один из наиболее известных подходов называется magnitude pruning. Его логика достаточно проста: если абсолютное значение определенного веса очень мало, его влияние на результат слоя часто оказывается меньше, чем у параметра с большим значением. Поэтому веса сортируют по модулю и обнуляют наименьшие. Например, если слой содержит 10 миллионов весов и задан уровень pruning 30 процентов, алгоритм может выбрать 3 миллиона наименее значимых по выбранному критерию параметров и заменить их нулевыми значениями.
Однако маленький вес не всегда является бесполезным. Нейросеть представляет собой взаимосвязанную систему, и даже небольшой параметр может участвовать в важной комбинации с другими. Поэтому pruning обычно рассматривают как компромисс между степенью разреженности и качеством модели. Чем агрессивнее сокращение, тем выше вероятность того, что модель потеряет часть способности правильно обрабатывать данные.
Именно поэтому на практике pruning часто сопровождается дополнительным дообучением. После удаления части параметров оставшиеся веса получают возможность адаптироваться к новой структуре сети. TensorFlow Model Optimization Toolkit, например, рекомендует в типичных сценариях выполнять fine-tuning модели с pruning, а не просто удалять параметры у готовой сети без последующей адаптации.
Пример с простой нейросетью
Представим обученную сеть, содержащую 20 миллионов параметров. Допустим, исследование показывает, что существенная часть связей может быть обнулена без заметного ухудшения качества на контрольной выборке. Если применить pruning с целевой разреженностью 50 процентов, примерно половина выбранных параметров будет заменена нулевыми значениями.
На уровне обычной матрицы весов это можно представить как превращение плотной структуры в разреженную. До pruning почти каждая позиция содержит ненулевое значение. После pruning значительная часть ячеек содержит нули, а полезная информация сосредоточена в меньшем количестве связей. Если исходная модель имела 20 миллионов параметров, математически ненулевых параметров при 50-процентной разреженности останется примерно 10 миллионов.
Но из этого нельзя автоматически сделать вывод, что файл модели станет ровно в два раза меньше. Если веса по-прежнему записываются в плотном формате, нулевые значения занимают место так же, как и ненулевые. Для получения реальной экономии памяти нужны подходящие способы представления разреженных данных или дополнительное сжатие. TensorFlow прямо указывает, что для получения преимуществ от pruning при экспорте модели требуется корректно удалить служебные структуры pruning и применить обычное сжатие, например gzip, в соответствующих сценариях.
Unstructured pruning: удаление отдельных связей
Наиболее простой вариант называется unstructured pruning, то есть неструктурированное прореживание. В этом случае алгоритм может удалить отдельные веса независимо друг от друга. Например, в одной строке матрицы останутся ненулевые значения в позициях 1, 4 и 9, а в другой — в позициях 2, 3 и 8. Получившаяся матрица становится разреженной, но ее первоначальная геометрия сохраняется.
Главное преимущество такого подхода заключается в свободе выбора. Алгоритм может удалить именно те отдельные параметры, которые считает наименее важными. Благодаря этому можно получить высокую степень разреженности при сравнительно небольшом падении точности. PyTorch поддерживает такие методы, как L1Unstructured, где параметр выбирается для удаления на основе его L1-нормы, то есть фактически величины веса.
Недостаток становится заметен при реальном выполнении вычислений. Обычный процессор или графический ускоритель хорошо работает с плотными матрицами и регулярными операциями. Хаотично разбросанные нули могут не привести к пропорциональному сокращению времени вычислений. В результате модель формально содержит меньше ненулевых параметров, но программа все равно может выполнять вычисления над матрицами исходного размера.
Structured pruning: удаление целых структур
Structured pruning устроено иначе. Вместо отдельных элементов удаляются более крупные и регулярные части сети. В сверточной нейросети это могут быть целые фильтры или каналы, а в других архитектурах — группы нейронов или блоки параметров. Такой подход меняет саму вычислительную структуру модели, поэтому его преимущество заключается в том, что сокращение параметров легче превратить в реальное уменьшение вычислительной нагрузки.
Например, сверточный слой может первоначально иметь 128 выходных каналов. Если алгоритм определяет, что 32 из них можно удалить, следующий вариант модели будет содержать уже 96 каналов. Это отличается от ситуации, когда внутри всех 128 каналов просто обнуляются отдельные веса. Во втором случае размер тензора остается прежним, тогда как при структурном pruning уменьшается сама размерность операции.
TensorFlow отдельно рассматривает структурное разреживание и показывает, что регулярные шаблоны разреженности могут использоваться для ускорения inference на аппаратуре, которая их поддерживает. При этом более жесткие структурные ограничения способны сильнее влиять на точность модели по сравнению с произвольным удалением отдельных весов.
Что такое разреженность модели
Для описания результата pruning используется понятие sparsity, или разреженность. Если в выбранном наборе параметров 40 процентов значений равны нулю, говорят о 40-процентной разреженности. При 80-процентной разреженности ненулевыми остается только 20 процентов исходных элементов.
Разреженность удобно использовать для сравнения разных вариантов одной модели. Например, можно создать версии с 20, 40, 60 и 80 процентами разреженности, после чего протестировать каждую на одной и той же контрольной выборке. Такой эксперимент позволяет увидеть, где находится практический баланс между уменьшением модели и качеством результата.
При этом глобальная разреженность не означает, что каждый слой должен быть прорежен одинаково. Один слой может потерять 10 процентов параметров, другой — 50 процентов, а третий — практически не подвергаться pruning. В PyTorch глобальный pruning как раз позволяет выбирать параметры для удаления по общей совокупности нескольких тензоров, поэтому итоговая доля обнуленных элементов по отдельным слоям может различаться.
Почему разные слои нельзя сокращать одинаково
Нейросеть состоит из слоев, выполняющих разные функции. Некоторые из них могут иметь значительный запас параметров, тогда как другие оказываются критичными для формирования итогового результата. Поэтому равномерное удаление, например, 50 процентов весов из каждого слоя не всегда является оптимальным решением.
На практике часто проводят серию экспериментов, определяя чувствительность отдельных слоев к удалению параметров. Если после pruning конкретного слоя точность резко падает, его можно прореживать меньше либо оставить практически без изменений. TensorFlow в руководстве по pruning прямо рекомендует выборочно пропускать слои, которые сильнее всего влияют на точность, и отмечает, что в некоторых случаях поздние слои переносят pruning лучше первых.
Особенно осторожно следует относиться к небольшим, но функционально важным слоям. Если слой содержит относительно немного параметров, его удаление может дать небольшой выигрыш по размеру, но заметно изменить поведение всей сети. Поэтому процент pruning сам по себе не является достаточным показателем качества оптимизации.
Pruning до обучения и после обучения
Существует несколько стратегий применения pruning. Один вариант — взять уже обученную модель и начать удалять из нее параметры. Другой — включить механизм pruning в процесс дальнейшего обучения, постепенно увеличивая уровень разреженности. Второй подход позволяет сети адаптироваться к изменениям по мере их возникновения.
Постепенное увеличение разреженности может быть особенно полезным при серьезном сокращении модели. Вместо того чтобы сразу обнулить половину параметров, алгоритм начинает с небольшого уровня pruning, после чего в течение определенного количества шагов постепенно увеличивает его. TensorFlow Model Optimization Toolkit поддерживает такие расписания, включая постепенный переход от нулевой до целевой разреженности.
При этом pruning не обязательно применять ко всей сети. Можно ограничить его определенными слоями или типами параметров. Такой подход дает возможность сохранить наиболее чувствительные части архитектуры и одновременно значительно уменьшить объем менее критичных вычислений.
Как pruning влияет на размер файла
На первый взгляд кажется очевидным: если половина параметров стала нулевой, файл должен стать вдвое меньше. Но обычное хранение плотной матрицы так не работает. Если каждый вес занимает, например, 32 бита и программа продолжает сохранять каждую позицию массива, ноль занимает те же 32 бита, что и любое другое число.
Чтобы действительно сократить размер модели, можно использовать специальные форматы разреженного хранения. В них отдельно кодируется информация о ненулевых значениях и их расположении. При высокой разреженности это может оказаться существенно эффективнее плотного представления. Дополнительную экономию дает квантование, когда сами параметры хранятся с меньшей разрядностью.
Именно поэтому pruning часто рассматривается не изолированно, а как часть комплексной оптимизации. TensorFlow Model Optimization Toolkit объединяет pruning с другими методами, включая quantization и clustering. Каждая технология сокращает разные составляющие стоимости модели: pruning уменьшает количество используемых связей, quantization уменьшает разрядность представления, а clustering сокращает число уникальных значений параметров.
Почему pruning не всегда ускоряет нейросеть
Уменьшение количества ненулевых параметров и ускорение inference — не одно и то же. Если вычислительная библиотека не умеет эффективно работать с конкретным типом разреженности, она может продолжать обрабатывать исходную плотную структуру. В этом случае pruning способен уменьшить объем данных после сжатия, но почти не изменить время выполнения.
По этой причине при выборе метода pruning необходимо учитывать целевое оборудование. Для серверного GPU может иметь смысл один тип структурной разреженности, для мобильного процессора — другой, а для специализированного ускорителя — третий. Оптимальная структура модели определяется не только математикой нейросети, но и тем, какие операции умеет быстро выполнять конкретный аппаратный стек.
Хороший пример дает NVIDIA TensorRT. Для поддерживаемых GPU семейства Ampere и более новых архитектур TensorRT использует структурную разреженность 2:4: в каждой группе из четырех соответствующих элементов должно быть не более двух ненулевых значений. Такой регулярный шаблон позволяет специализированным вычислительным блокам эффективнее выполнять операции с разреженными весами. Однако даже если слой удовлетворяет требованиям, TensorRT не обязан выбирать sparse-реализацию: в некоторых размерах задачи обычный плотный алгоритм может оказаться быстрее.
Что означает pruning 2:4
Схема 2:4 является примером структурированного pruning. Представим последовательность из четырех весов: [0, 1, 0, 2]. В ней два значения равны нулю, а два остаются ненулевыми. Если каждая группа из четырех элементов соответствует требованиям целевого ускорителя, такой шаблон может быть обработан специальными sparse-операциями.
При идеальном применении 2:4 половина элементов в соответствующих группах становится нулевой. Но это не означает автоматического двукратного ускорения всей нейросети. На итоговое время влияют архитектура модели, доля операций, использующих поддерживаемую разреженность, размеры матриц, тип данных, память и конкретные реализации вычислительных ядер. NVIDIA прямо отмечает, что даже среди подходящих слоев TensorRT может выбрать обычную плотную реализацию, если она показывает лучшую производительность для конкретной задачи.
Связь pruning с точностью модели
Главный риск прореживания — ухудшение качества. Обученная модель использует множество параметров совместно, поэтому невозможно заранее гарантировать, что удаление определенного количества весов никак не повлияет на результат. Чем выше уровень pruning, тем более внимательно необходимо контролировать точность на независимой валидационной выборке.
Например, модель классификации изображений после умеренного pruning может сохранить практически исходную точность. При дальнейшем увеличении разреженности результат может постепенно ухудшаться, а затем наступить резкий провал. Поэтому график зависимости точности от sparsity часто оказывается гораздо информативнее одного показателя размера модели.
Если после pruning качество снизилось, модель можно дообучить. Оставшиеся параметры получают возможность компенсировать часть удаленных связей. В некоторых сценариях это позволяет значительно уменьшить количество параметров без пропорционального ухудшения качества. Но универсального процента безопасного pruning не существует: результат зависит от архитектуры, набора данных, задачи и конкретной стратегии удаления.
Pruning больших языковых моделей
Для крупных языковых моделей проблема становится особенно интересной из-за огромного количества параметров. Удаление отдельных весов способно создать чрезвычайно разреженные матрицы, но выигрыш от такого подхода зависит от поддержки разреженных операций в используемом программном и аппаратном стеке.
Более структурные методы могут воздействовать на крупные блоки модели. В зависимости от архитектуры можно рассматривать удаление отдельных голов внимания, групп каналов, блоков или других повторяющихся компонентов. Такой подход потенциально позволяет уменьшить не только число параметров, но и сам объем вычислений. Однако слишком агрессивное удаление структур способно нарушить способность модели обрабатывать определенные типы информации.
Для языковых моделей особенно важен выбор того, какие части архитектуры можно сокращать без существенного изменения поведения. Поэтому современные исследования pruning обычно рассматривают не только абсолютную величину отдельных весов, но и влияние структуры на качество, вычислительную стоимость и способность модели сохранять исходные характеристики.
Чем pruning отличается от квантования
Pruning и quantization часто упоминаются вместе, но решают разные задачи. При pruning часть параметров удаляется или превращается в нули. При квантовании параметры не обязательно удаляются: вместо этого их представление переводится в более компактный формат, например с 32-битных чисел с плавающей точкой на 8-битные значения.
Если модель содержит 100 миллионов параметров, pruning может уменьшить количество используемых связей, а quantization — уменьшить количество битов, необходимых для хранения каждого оставшегося параметра. Поэтому две технологии можно комбинировать. TensorFlow рассматривает их как взаимодополняющие методы оптимизации моделей и отдельно описывает collaborative optimization, в рамках которой несколько техник применяются совместно.
Как выглядит практический процесс pruning
В реальном проекте оптимизацию обычно начинают с базовой модели. Сначала фиксируются исходные показатели: размер файла, количество параметров, точность, задержка inference, потребление памяти и, если важно для проекта, энергопотребление. После этого выбирается метод pruning и задается целевая степень разреженности.
Затем модель подвергают прореживанию и проверяют качество. Если показатели остаются приемлемыми, можно увеличить sparsity и повторить эксперимент. После каждого этапа желательно проводить fine-tuning, особенно если удаляется значительная часть параметров. В результате получается несколько вариантов модели, которые сравниваются уже не только по точности, но и по фактической скорости работы на целевом устройстве.
Последний этап принципиален. Нельзя считать оптимизацию успешной только потому, что число ненулевых параметров уменьшилось. Если приложение должно работать на конкретном GPU, CPU или специализированном ускорителе, именно там следует измерять итоговую задержку. Модель, которая на бумаге имеет меньше параметров, может оказаться практически такой же быстрой, как исходная, если аппаратное обеспечение не использует созданную разреженность.
Какие ошибки часто допускают при pruning
Одна из самых распространенных ошибок заключается в стремлении сразу добиться максимальной разреженности. Если просто удалить 80–90 процентов параметров без проверки промежуточных результатов, можно получить модель, которая формально стала значительно меньше, но потеряла существенную часть исходного качества.
Вторая ошибка — считать количество нулей эквивалентом уменьшения размера файла. Нулевая матрица в плотном формате может занимать практически столько же места, сколько исходная. Третья — оценивать ускорение только по теоретическому числу удаленных операций. Реальная производительность определяется конкретной реализацией вычислений и поддержкой выбранного шаблона sparsity.
Еще одна проблема — одинаковый процент pruning для всех слоев. Разные части нейросети обладают разной чувствительностью к удалению параметров. Поэтому более разумный подход заключается в поиске индивидуального баланса: критические слои сохраняются почти полностью, а менее чувствительные подвергаются более глубокому сокращению.
Почему pruning особенно важен для периферийных устройств
На сервере можно компенсировать большую модель мощным GPU и большим объемом оперативной памяти. На периферийном устройстве такая возможность часто отсутствует. Смартфон, камера, робот, автомобильный контроллер или промышленный датчик располагают ограниченным объемом памяти и вычислительной мощностью. Кроме того, для автономных устройств важна энергия аккумулятора.
Именно поэтому уменьшение модели становится не только вопросом удобства, но и частью архитектуры продукта. TensorFlow отмечает среди задач model optimization снижение задержки и стоимости inference, уменьшение потребления памяти и возможность развертывания моделей на устройствах с ограничениями по вычислениям, памяти и энергии.
Для обновляемых моделей есть и еще один практический эффект. Чем меньше модель, тем меньше данных требуется передавать при обновлении программного обеспечения. Это особенно важно для большого парка устройств, которые получают обновления через мобильную сеть или соединение с ограниченной пропускной способностью.
Главная идея pruning
Pruning можно представить как поиск более компактной версии уже обученной нейросети. Вместо того чтобы считать каждый параметр одинаково необходимым, алгоритм определяет, какие связи или структуры можно убрать, сохранив приемлемое качество результата. В простейшем случае удаляются веса с небольшой величиной, в более продвинутых методах сокращаются целые каналы, блоки или заранее заданные группы параметров.
Однако настоящее уменьшение нейросети происходит только тогда, когда результат pruning поддерживается последующими этапами хранения и вычисления. Разреженная матрица должна эффективно сохраняться, а вычислительная система — уметь использовать созданную структуру. Поэтому pruning является не просто способом поставить нули в матрице весов, а частью более широкой задачи оптимизации машинного обучения.
Заключение
Pruning позволяет уменьшать обученные нейросети за счет удаления части параметров, связей или структурных элементов, которые не являются критичными для работы модели. Наиболее простой вариант — обнуление отдельных малых по величине весов. Более сложные методы удаляют целые каналы, фильтры или регулярные блоки, благодаря чему сокращается уже сама вычислительная структура.
При грамотном применении pruning способен уменьшить объем хранимых данных, снизить вычислительную нагрузку и облегчить развертывание моделей на устройствах с ограниченными ресурсами. Но процент удаленных параметров нельзя рассматривать отдельно от качества и реальной скорости работы. Высокая разреженность не гарантирует пропорционального ускорения, а нулевые веса не обязательно уменьшают файл, если используется плотное хранение.
Наиболее практичный подход заключается в последовательном тестировании разных уровней разреженности, выборочном pruning чувствительных и менее чувствительных слоев, последующем дообучении и обязательном измерении производительности на целевом оборудовании. В сочетании с квантованием и другими методами оптимизации pruning становится одним из инструментов превращения большой обученной нейросети в более компактную и удобную для реального применения модель.
Об авторе